
Google, metinden sese üretim tarafında iki yeni modeli kullanıma açtı: Gemini 3.8 Flash TTS ve Gemini 3.8 Flash-Lite TTS. Şirket bu iki modeli aynı anda sunarak iş yüklerini iki ayrı sınıfa ayırıyor. Gemini 3.8 Flash TTS daha çok etkileşimli eğlence, oyun geliştirme ve uzun anlatım kayıtları gibi yaratıcı kontrolün önemli olduğu alanlara odaklanırken, Gemini 3.8 Flash-Lite TTS ise otomatik dublaj, müşteriyle konuşan sesli ajanlar ve yüksek hacimli çeviri hatları için konumlandırılıyor.
Yeni modeller, Google’ın daha önce duyurduğu 3.5 Live Translate, 3.5 Transcribe, 3.8 Live ve 3.8 Live Extended Thinking serisini tamamlayan bir genişleme niteliğinde. Teknik tarafta dikkat çeken değişimlerden biri, sabit yapıda sunulan 30 eski ses kataloğunun yerine çok daha geniş bir havuzun gelmesi. Geliştiriciler artık 100’den fazla dili kapsayan ve Quebec French, Scots English, Mexican Spanish gibi bölgesel varyasyonları içeren 2.000’den fazla hazır ses profiline erişebiliyor.
Google ayrıca yakında sunulacak bir voice remixing modülünden de söz ediyor. Bu sistemle ses mühendisleri, doğrudan metin komutları üzerinden tını, perde, konuşma hızı ve aksan karakteristiği gibi unsurları ayarlayabilecek. Böylece klasik ön tanımlı ses seçiminin ötesine geçilip, daha esnek bir üretim akışı kurulması hedefleniyor.
Bağımsız değerlendirmelerde büyük model öne çıkmış durumda. Hume AI Voice Design Benchmark sonuçlarına göre Gemini 3.8 Flash TTS, toplamda 71.4 puan aldı. Aksan modelleme kategorisinde ise 60.8 ile listenin başına yerleşti. Hume AI Overall Quality Index tarafında da Gemini 3.8 Flash TTS ilk sırada, Gemini 3.8 Flash-Lite TTS ise ikinci sırada gösteriliyor. Her iki model de bu ölçümlerde Gemini 3.1 Flash TTS için daha önce belirlenen taban sonuçların üzerine çıkmış görünüyor.
İnsan değerlendirmelerine dayalı çift kör testlerde de bölgesel dillerde tercih avantajı bildiriliyor. Japonca, Brazilian Portuguese, Vietnamese, Modern Standard Arabic, Mexican Spanish ve Hindi gibi diller bu sonuçlarda özellikle anılan örnekler arasında yer alıyor. Bu da sistemlerin yalnızca İngilizce merkezli bir optimizasyonla sınırlı kalmadığını gösteriyor.
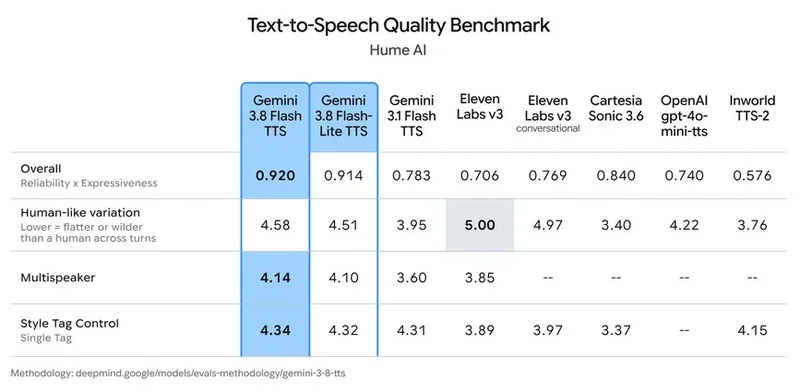
Yeni modellerin bir diğer odak noktası, çok konuşmacılı sahneleme ve uzun süreli sentez üretimi. Tek bir senaryo metni üzerinden iki konuşmacılı diyaloglar yönetilebiliyor; sistem konuşma sıralamasını ve ses ayrımını uzun diyaloglar boyunca koruyabiliyor. Google, çok saatlik dosyalarda ses kalitesi ve karakter tınısının istikrarlı kaldığını, bunun da sesli kitap ve bölümlü podcast üretiminde zamanla oluşan bozulmayı azaltabileceğini belirtiyor.
Yazım tarafında da üretime dönük bazı araçlar eklenmiş durumda. İçerik üreticileri metin içine doğrudan , veya gibi sözsüz akustik işaretler ekleyebiliyor. Buna ek olarak |mhm| ve |yeah| benzeri kısa sözel tepkilerle konuşma ritmi daha doğal hale getirilebiliyor. Bu yaklaşım özellikle karakter odaklı diyaloglarda ve sohbet benzeri akışlarda faydalı olabilir.
Güvenlik tarafında ise ses klonlama için zorunlu kimlik doğrulama kontrolleri uygulanıyor. Özel bir ses profilini yeniden oluşturmak için 30 saniyelik referans kayıt isteniyor. Buna ek olarak, orijinal ses sahibinin açık sözlü onayını içeren ayrı bir ses kaydı gerekiyor. Sistem, işleme geçmeden önce bu iki kayıt arasında akustik uyumu doğruluyor. Amaç, taklit ve yetkisiz ses çoğaltma riskini düşürmek.
Üretilen ses dosyalarına görünmez SynthID ses filigranı ve C2PA tabanlı kriptografik kaynak metadata’sı ekleniyor. Böylece sentetik ses içeriklerinin sonraki aşamalarda tespit araçlarıyla ayırt edilebilmesi amaçlanıyor. Dağıtım tarafında modeller Google AI Studio ve standart Gemini API üzerinden geliştiricilere açılmış durumda. Agora, LiveKit, Pipecat ve Vercel tabanlı çerçevelerle bağlantı veriliyor. Son kullanıcı tarafında Flash TTS, Gemini Notebook içinde; Flash-Lite TTS ise Google Vids içinde yer alıyor. Gemini Enterprise müşterileri için yönetimsel API erişiminin ise daha sonraki bir dağıtım dalgasında sunulacağı belirtiliyor.
