
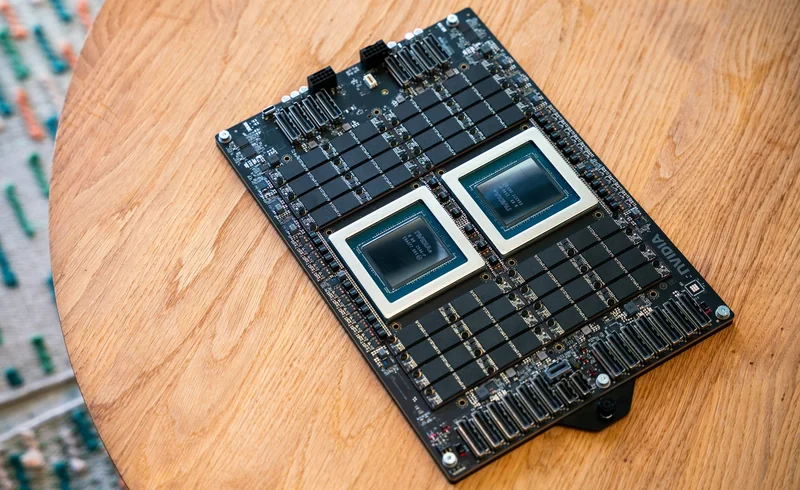
NVIDIA, Vera adını verdiği yeni nesil sunucu işlemcisini klasik genel amaçlı CPU anlayışından farklı bir konuma yerleştiriyor. Şirketin anlatımına göre Vera, çok farklı iş parçacıklarını eş zamanlı yürüten geleneksel bir merkez işlemci olmaktan çok, agentic AI iş akışlarında CPU ile GPU arasında sürekli gidip gelen çok adımlı muhakeme döngülerini düzenleyen özel bir “orkestra şefi” gibi tasarlandı. Bu yaklaşım, veri merkezi tarafında son yıllarda öne çıkan yüksek çekirdek sayısı odaklı tasarım çizgisinden belirgin bir kopuş anlamına geliyor.
Geçmişte veri merkezi işlemci tasarımlarında öncelik, çekirdek başına yüksek performanstı. Özellikle 2010’ların başında daha az sayıda ama daha yüksek frekansta çalışan çekirdekler öne çıkıyordu. Daha sonra hyperscaler bulut işletmecilerinin büyümesiyle denge değişti; tek sunucuda mümkün olduğunca fazla çekirdeğe yer vermek, gelir ve yoğunluk açısından daha önemli hale geldi. Bu dönüşümle birlikte x86 üreticileri tek kalıp tasarımdan çok yongacıklı yapılara yöneldi. Ancak bu model, çekirdek başına performans ve IPC tarafında bazı ödünleri beraberinde getirdi.
NVIDIA’ya göre agentic AI bu dengeyi yeniden tersine çeviriyor. Bunun nedeni, AI ajanlarının GPU ve CPU arasında çok sık ve hızlı bir döngü içinde çalışması. GPU’lar bir AI altyapısındaki en pahalı ve en değerli kaynaklar arasında yer aldığı için, CPU tarafında yapılan sıralı işler mümkün olduğunca hızlı tamamlanmalı. Aksi halde GPU’nun boşta kalması söz konusu olabiliyor. Bu nedenle yalnızca yüksek toplam iş hacmi değil, aynı zamanda güçlü tek iş parçacığı performansı, yüksek bellek bant genişliği ve düşük gecikme de kritik hale geliyor.
Vera’nın temel iddiası da burada başlıyor. NVIDIA, bu işlemciyi bulut döneminin klasik ödünleşmesini kıran bir tasarım olarak tanımlıyor: hem yüksek tek iş parçacığı performansı hem de yüksek toplam throughput. Şirket bunu üç ana unsurla açıklıyor. İlki, çekirdek başına yüksek hız. İkincisi, yüksek bant genişliği için özel LPDDR5X bellek alt sistemi. Üçüncüsü ise gecikmeyi azaltmak için ikinci nesil NVIDIA Scalable Coherent Fabric ile desteklenen tek parça, monolitik bir hesaplama kalıbı. Tüm çekirdeklerin tek bir kalıp üzerinde bulunması, çekirdekler arası iletişimde ek I/O sınırlarının yarattığı gecikmeleri ortadan kaldırmayı hedefliyor.
Bu mimari tercih, NVIDIA’nın CPU tarafındaki stratejisinde de bir değişime işaret ediyor. Grace döneminde odak daha çok GPU kümelerini besleyen ideal “host node” oluşturmaktı. Yani CPU, esasen raf içindeki GPU altyapısına yardımcı olan bir bileşen konumundaydı. Ancak agentic iş akışları ve reinforcement learning yükleri, sadece GPU’ları destekleyen CPU’lardan daha fazlasını gerektiriyor. Şirket, belirli senaryolarda yalnızca CPU’lardan oluşan bağımsız rafların da anlamlı hale geldiğini söylüyor. Özellikle ajan araç çağrıları ve reinforcement learning tarafında, büyük hacimli CPU işi doğrudan bağımsız işlemci kümelerine kayabiliyor.
Bu yüzden Vera artık yalnızca birleşik bir CPU-GPU yığınının parçası olarak değil, tek başına ticarileştirilecek bir işlemci varlığı olarak konumlanıyor. NVIDIA, Vera tabanlı “pure racks” yaklaşımıyla sadece CPU içeren sistemlerin agent tool call ve muhakeme döngülerini işlemesi fikrini öne çıkarıyor. Şirket bunu daha geniş bir ayrıştırma eğiliminin parçası olarak görüyor. Zaten güncel AI çıkarım altyapılarında pre-fill ve decode aşamalarının farklı donanım kümelerine ayrılması giderek daha yaygın hale gelmiş durumda. Vera’nın bağımsızlaştırılması da benzer bir uzmanlaşma adımı olarak okunabilir.
Performans tarafında paylaşılan rakamlar da bu yeni konumlandırmayı desteklemeyi amaçlıyor. NVIDIA’ya göre Vera, Grace’e kıyasla 1.5x daha yüksek performans sunuyor. Agentic iş yüklerinde ise, özellikle Python betikleri ve LLVM derleme gibi sıralı görevlere ağırlık veren senaryolarda, önde gelen x86 işlemcilere karşı 2x’e kadar hızlanma sağlanabildiği belirtiliyor. Geometrik ortalama bazında avantajın 1.6x düzeyinde olduğu ifade ediliyor. Bu noktada şirketin vurgusu, sentetik tepe değerlerden çok ajan tabanlı iş akışlarında gerçek darboğaz oluşturan sıralı CPU bölümlerine odaklanmak.
NVIDIA’nın dikkat çektiği bir diğer unsur ise eşzamanlı çoklu iş parçacığına alternatif yaklaşımı. Şirket, klasik Simultaneous Multithreading yerine Spatial Multithreading adını verdiği CPU-yerel bir yöntemi kullanıyor. Bu yapıda belirli iş parçacıkları “worker”, diğerleri ise “I/O” görevi için ayrılabiliyor. Amaç, ağır veri merkezi yükleri altında arka plan işlemlerinin ana hesaplama iş parçacıklarının çevrimlerini tüketmesini önlemek. Böylece kaynak tahsisi daha öngörülebilir hale geliyor ve işlemci, giriş/çıkış baskısı altında dahi ana iş yüküne gereken zamanı ayırabiliyor.
Bu tür özel zamanlama yaklaşımlarında doğal olarak ek gecikme veya verim kaybı olup olmadığı sorusu gündeme geliyor. NVIDIA, Vera’daki Spatial Multithreading için böyle bir performans cezası bulunmadığını savunuyor. Hatta üçüncü taraf testlerde yaklaşık %20 düzeyinde performans artışı görüldüğünü aktarıyor. Şirketin verdiği örneğe göre bu mekanizma, özellikle veri merkezi genelinde yükün arttığı anlarda işçi iş parçacıklarının I/O talepleri uğruna geri plana atılmasını önlediği için verimlilik kazancı sağlayabiliyor.
CPU ile GPU arasındaki ideal oran konusunda ise NVIDIA net bir sayı vermiyor. Sektörde zaman zaman 80:1 gibi iddialı CPU/GPU oranları konuşulsa da şirket bunu resmi bir hedef olarak benimsemiyor. Buna rağmen yönün CPU tarafına kaydığını açık biçimde kabul ediyor. Gerekçe olarak da agent tool call hacminin büyüklüğü gösteriliyor. Bazı sandbox sağlayıcılarının tek bir müşteri için 400.000 adede kadar sandbox barındırabildiği, ileride ise çalışır durumdaki sandbox sayısının trilyonlar seviyesine uzanabileceği ifade ediliyor. Böyle bir tabloda bağımsız CPU raflarına olan ihtiyaç doğal olarak artıyor.
Vera’nın monolitik kalıp tercihinin arkasındaki mantık da tam burada şekilleniyor. NVIDIA, Intel ve AMD gibi uzun yıllardır hem istemci hem veri merkezi segmentine aynı mimari ailelerle hizmet veren şirketlerin aksine, Vera’yı doğrudan yüksek performanslı AI veri merkezi hedefiyle tasarladığını söylüyor. Bu “miras yükünden bağımsız” yaklaşım, tasarım kararlarını daha dar ama daha net bir hedefe göre vermeyi mümkün kılmış. Agentic AI ve veri analitiği gibi yüklerde çekirdekler arası veri hareketi önemli olduğundan, çok yongacıklı yapılardaki sınırların getirdiği gecikme ve ek maliyetlerden kaçınmak öncelik haline gelmiş durumda.
Şirketin bu konuda öne çıkardığı en somut rakam 3.4 TB/s bisection bandwidth değeri. NVIDIA’ya göre Vera, bu sayede paylaşılan bağlam üzerinde birlikte çalışan çekirdeklerin iletişimini önde gelen x86 işlemcilere kıyasla 3x daha hızlı gerçekleştirebiliyor. Çekirdeklerin yonganın bir ucundan diğer ucuna I/O sınırı aşmadan erişebilmesi, özellikle ortak veri kümeleri ve bağlamsal durum paylaşımı gereken iş yüklerinde avantaj sağlıyor. NVIDIA bunu yalnızca agentic AI için değil, genel veri işleme ve veri analitiği için de önemli bir tasarım noktası olarak sunuyor.
Bununla birlikte şirket, chiplet yaklaşımına ideolojik biçimde karşı olmadığını da belirtiyor. Vera için monolitik kalıp matematiksel olarak gerekli görülen performans hedeflerine daha uygun bulunmuş. Ancak gelecekte pazar ihtiyaçları farklı bir yön gösterirse, chiplet tasarımına geçiş ihtimali dışlanmıyor. Yani burada sabit bir tasarım dogmasından çok, hedef iş yüküne göre araç seçme yaklaşımı öne çıkıyor.
Genel çerçevede bakıldığında Vera, NVIDIA’nın CPU’yu yeniden veri merkezinin merkezine taşıma girişimi olarak değerlendirilebilir. Şirket, agentic AI döneminde CPU’nun sadece yardımcı bir bileşen değil, GPU verimliliğini doğrudan belirleyen kritik bir unsur olduğunu savunuyor. Yüksek tek iş parçacığı performansı, yüksek bant genişliği, düşük gecikme, bağımsız CPU rafları ve monolitik kalıp tasarımı gibi tercihler de bu argümanın etrafında şekilleniyor. Vera’nın başarısı, büyük ölçüde agentic AI iş yüklerinin gerçekten NVIDIA’nın tarif ettiği ölçekte CPU ağırlıklı büyüyüp büyümeyeceğine bağlı olacak. Mevcut anlatı ise veri merkezinde CPU tasarım önceliklerinin yeniden değişmeye başladığını gösteriyor.
